修改一个公共函数之前,我们常常要先回答两个问题:谁在调用它?改动可能影响哪些上层模块?
调用点不多时,用编辑器跳转就能找到答案。调用链一长,就得逐层查看函数、记录路径,再整理涉及的文件。有了调用关系数据,这些工作可以交给图查询。
下面用 NeuG 存储一张代码依赖图:先定义模型、导入 CSV,再查找直接和间接调用者,最后列出它们所在的文件。
本文示例已在 NeuG 0.2.0、Python 3.11.9、macOS 15.1.1 / ARM64 上运行验证。数据为人工构造,不涉及真实项目。文档核对日期为 2026 年 9 月 30 日。
为什么用 NeuG 做这个例子
NeuG 支持图数据存储和 Cypher 查询,既可以嵌入应用进程,也可以通过服务访问。本篇使用 Python 嵌入式接口:在脚本中打开数据库、建立连接,直接执行查询,无需另外启动数据库服务。官方介绍
A 调用 B,可以表示为一条从 A 指向 B 的边。函数与源文件之间再加一条“定义于”关系,就能从调用链查到文件。
这组数据很小,用字典和遍历算法也能处理。用它入门的好处是,每条查询的结果都可以对着图核对。
先把调用关系画出来
假设项目中有三个文件,共八个函数。
| 文件 | 函数 |
|---|---|
api.py | handle_request、format_response、health_check |
service.py | build_report、load_user、load_orders |
storage.py | read_cache、query_db |
调用关系如下,箭头始终从调用者指向被调用者:
handle_request ──→ load_user ──→ read_cache │ └─────→ query_db └────────→ format_response
build_report ───→ load_user └────────→ load_orders ──→ query_db
health_check (没有调用边)我们准备修改的函数是 query_db。从图上可以看出,load_user 和 load_orders 直接调用它;handle_request 和 build_report 则通过其他函数间接依赖它。稍后可以用查询核对。
这张图需要两类节点和两类关系。
Function:函数,保存编号id和名称name。File:文件,保存编号id和路径path。CALLS:从函数指向它调用的函数。DEFINED_IN:从函数指向定义它的文件。
函数名只是用于展示的属性,编号才是本例的主键。实际项目可能有同名函数,不能直接用短名称判断它们是不是同一个实体。
安装与创建数据库
先创建独立的 Python 环境,再安装本文验证过的版本:
python3.11 -m venv .venvsource .venv/bin/activatepython -m pip install "neug==0.2.0"安装方式参考官方安装指南。本文只验证了上述 macOS 环境,其他系统的安装要求请以官方文档为准。
新建一个工作目录,把下面的 Python 代码按顺序写进同一个脚本,并在该目录中运行。脚本先创建数据库目录,再打开连接:
from pathlib import Pathimport neug
# 首次运行使用新目录,避免重复导入。db_path = Path("code_graph_db")db_path.mkdir(exist_ok=False)
db = neug.Database(str(db_path))conn = db.connect()再次运行完整脚本时,请换一个工作目录;exist_ok=False 会在数据库目录已存在时报错,避免误用旧数据。如果只想查询已有数据,跳过目录创建、建表和导入,直接打开原目录即可。数据库与连接说明
定义模型,再导入数据
先创建节点表和关系表:
schema = [ "CREATE NODE TABLE Function(id INT64, name STRING, PRIMARY KEY(id))", "CREATE NODE TABLE File(id INT64, path STRING, PRIMARY KEY(id))", "CREATE REL TABLE CALLS(FROM Function TO Function)", "CREATE REL TABLE DEFINED_IN(FROM Function TO File)",]for statement in schema: conn.execute(statement)FROM 和 TO 对应关系的起点和终点。例如,DEFINED_IN 从函数出发,指向文件。节点表主键和关系表的定义方式可查阅 DDL 文档。
接着准备四份 CSV。下面直接用 Python 写出文件,也可以替换成其他工具导出的 CSV。
import csv
files = [(1, "api.py"), (2, "service.py"), (3, "storage.py")]functions = [ (1, "handle_request"), (2, "build_report"), (3, "load_user"), (4, "load_orders"), (5, "read_cache"), (6, "query_db"), (7, "format_response"), (8, "health_check"),]calls = [(1, 3), (1, 7), (2, 3), (2, 4), (3, 5), (3, 6), (4, 6)]defined_in = [(1, 1), (2, 2), (3, 2), (4, 2), (5, 3), (6, 3), (7, 1), (8, 1)]
datasets = [ ("functions.csv", ["id", "name"], functions), ("files.csv", ["id", "path"], files), ("calls.csv", ["source", "target"], calls), ("defined_in.csv", ["source", "target"], defined_in),]for filename, header, rows in datasets: with open(filename, "w", newline="") as f: writer = csv.writer(f) writer.writerow(header) writer.writerows(rows)例如,calls.csv 中的 3,6 表示编号为 3 的 load_user 调用编号为 6 的 query_db。
用 COPY FROM 导入数据,先导入节点,再导入关系:
imports = [ "COPY Function FROM 'functions.csv' (header=true, delimiter=',')", "COPY File FROM 'files.csv' (header=true, delimiter=',')", """COPY CALLS FROM 'calls.csv' (header=true, delimiter=',', from='Function', to='Function')""", """COPY DEFINED_IN FROM 'defined_in.csv' (header=true, delimiter=',', from='Function', to='File')""",]for statement in imports: conn.execute(statement)节点 CSV 的列顺序与表定义保持一致。关系 CSV 的前两列分别是起点和终点的主键值,from、to 则指定端点所属的节点表。这里的相对文件路径以运行 Python 时的工作目录为基准。CSV 导入说明
不要省略本例中的 delimiter=','。 在本次验证环境中,省略这个选项后,导入报了“识别出 1 列、预期 2 列”的错误;显式指定逗号后导入成功。
导入完成后,先核对数量:
checks = [ "MATCH (n:Function) RETURN count(n)", "MATCH (n:File) RETURN count(n)", "MATCH (:Function)-[r:CALLS]->(:Function) RETURN count(r)", "MATCH (:Function)-[r:DEFINED_IN]->(:File) RETURN count(r)",]for query in checks: print(list(conn.execute(query)))四个结果应依次是 [[8]]、[[3]]、[[7]] 和 [[8]],对应函数数、文件数、调用边数和归属边数。如果不一致,先检查导入数据。
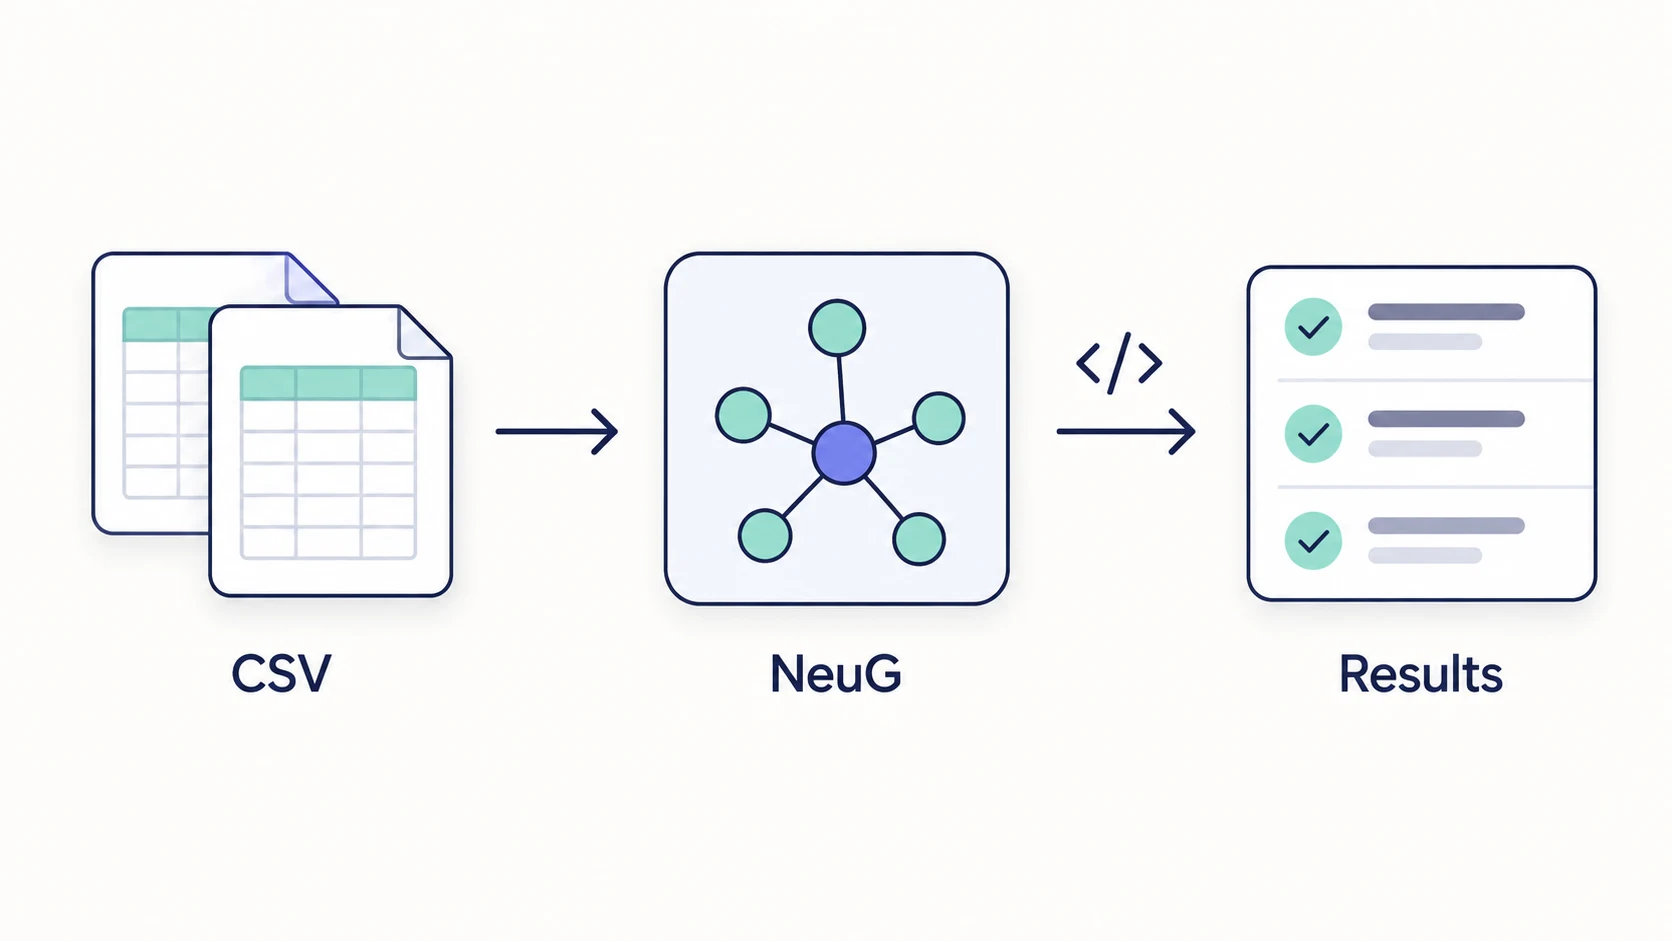
CSV 导入与图查询的流程示意。
第一次查询:谁直接调用了 query_db
把下面的 Cypher 交给 conn.execute():
query = """MATCH (caller:Function)-[:CALLS]->(target:Function {id: 6})RETURN caller.name AS nameORDER BY name"""for row in conn.execute(query): print(row)输出:
['load_orders']['load_user'](caller:Function) 匹配函数节点,[:CALLS] 匹配调用关系,右侧的 {id: 6} 将目标限定为 query_db。这条查询只查直接调用者。
RETURN 指定要输出的属性,ORDER BY 让结果顺序稳定,方便核对。函数在 CSV 中的排列顺序不应被当作查询结果的默认排序。
第二次查询:沿调用链找到上层函数
直接调用者之外,我们还希望找到 handle_request 和 build_report。把一条边扩展为长度在 1 到 3 之间的路径:
MATCH (caller:Function)-[:CALLS*1..3]->(target:Function {id: 6})RETURN DISTINCT caller.id AS id, caller.name AS nameORDER BY id将这段 Cypher 替换到上一段 Python 的 query 字符串中,保持逐行打印的代码不变,输出为:
[1, 'handle_request'][2, 'build_report'][3, 'load_user'][4, 'load_orders']*1..3 表示路径包含 1 到 3 条调用边。这张示例图的相关路径最多只有两条边,因此这个范围覆盖了图中所有上层调用者;如果某个调用者只能通过四条及以上的调用边到达目标,它就不会被返回。多跳模式语法
build_report 有两条路径能到达 query_db:一条经过 load_user,另一条经过 load_orders。DISTINCT 把重复的调用者合并。返回列保留了主键 id,即使两个函数同名,也不会被误合并。
真实调用图可能有递归和环。这里保留三层上限,限定本次查询的范围;需要追溯更深的依赖时,再调整上限。
第三次查询:这些调用者分布在哪些文件
接下来仍然替换 query 字符串,沿 DEFINED_IN 关系查出调用者所在的文件:
MATCH (caller:Function)-[:CALLS*1..3]->(target:Function {id: 6}), (caller)-[:DEFINED_IN]->(file:File)RETURN DISTINCT file.path AS pathORDER BY path输出:
['api.py']['service.py']两个模式共享变量 caller:第一个模式找到上层调用者,第二个模式找到这些调用者所在的文件。
结果只包含上层调用者所在的文件,因此没有 storage.py。目标函数 query_db 自身不在这份调用者名单中;同一文件中的 read_cache 也没有调用它。如果要形成完整的改动检查清单,可以另外加入目标函数所在文件。
上一条函数查询也没有返回 format_response 和 health_check:图中没有从它们到 query_db 的调用路径。不过,调用图无法涵盖所有影响。例如,共享数据格式发生变化时,没有调用关系的代码也可能需要调整。
关闭以后,数据还在吗
完成查询后,关闭连接和数据库。随后用同一个目录重新打开:
conn.close()db.close()
db = neug.Database(str(db_path))conn = db.connect()try: result = conn.execute("MATCH (n:Function) RETURN count(n)") print(list(result)) # [[8]]finally: conn.close() db.close()这里只重新打开数据库,不再执行建表和导入。配套脚本还会在重新打开后再次检查前面的三组查询。
本次验证覆盖了正常关闭后的重新打开,未进行进程崩溃或机器掉电测试,也没有做性能测试。八个函数的例子适合检查语法和结果,不能用来推断大型代码仓库的查询表现。
从示例走向真实代码库
接入真实代码库时,可以把这四份 CSV 换成代码分析工具的输出。导入和查询的步骤相同,数据本身则要处理好下面几个问题。
首先是身份识别。真实函数应有稳定的标识,至少要考虑仓库、文件路径和限定名称;本文的整数编号只是为了让数据容易阅读。
其次是调用关系的来源。动态分派、反射、函数指针和生成代码,都可能让关系提取出现遗漏或不确定性。将“明确解析的调用”和“推测的调用”区分开,查询结果才容易解释。
最后是版本一致性。代码更新后,需要同步替换失效的节点和关系,避免把不同版本的函数混在一张图里。
你可以先做一个小练习:在 calls 数据中增加 (8, 6),表示 health_check 调用 query_db,然后在新的数据库中重新导入。直接调用者应增加 health_check,而文件名单仍然是 api.py 和 service.py,因为 api.py 本来就在结果中。
配套示例
配套示例包中的 demo.py 自动生成四份 CSV,在临时目录中创建数据库,核对节点和边数量,检查三组查询结果,并在正常关闭后重新打开数据库再次验证。运行结束会清理它创建的临时目录,不修改已有数据库。
python demo.py脚本中的结果断言全部通过后,会输出 Reopen check: passed。修改示例数据后,也要相应更新 QUERIES 中的预期结果和数量断言。
参考资料
本文主要参考 NeuG 官方文档,以下链接分别对应安装、建模、导入和查询步骤。文档核对日期:2026 年 9 月 30 日;示例验证版本:NeuG 0.2.0。在线文档可能随版本更新。
- NeuG — Introduction:了解 NeuG 的定位,以及嵌入式和服务两种使用方式。
- NeuG — Installation:Python 安装方法及运行环境要求。
- NeuG — Getting Started:创建数据库、建立连接,以及关闭连接和数据库的基本流程。
- NeuG — DDL Clause:节点表、主键和关系表的定义语法。
- NeuG — COPY FROM:CSV 导入、列顺序、关系端点及导入选项。
- NeuG — MATCH Clause:节点与关系模式匹配,以及指定路径长度的多跳查询。
- NeuG — Python Query Result:Python 查询结果对象的接口说明。
本文的代码依赖数据、查询组合和结果校验为独立编写的教学示例;具体输出以配套脚本的运行结果为依据。